定位:把训练过程也一起开源
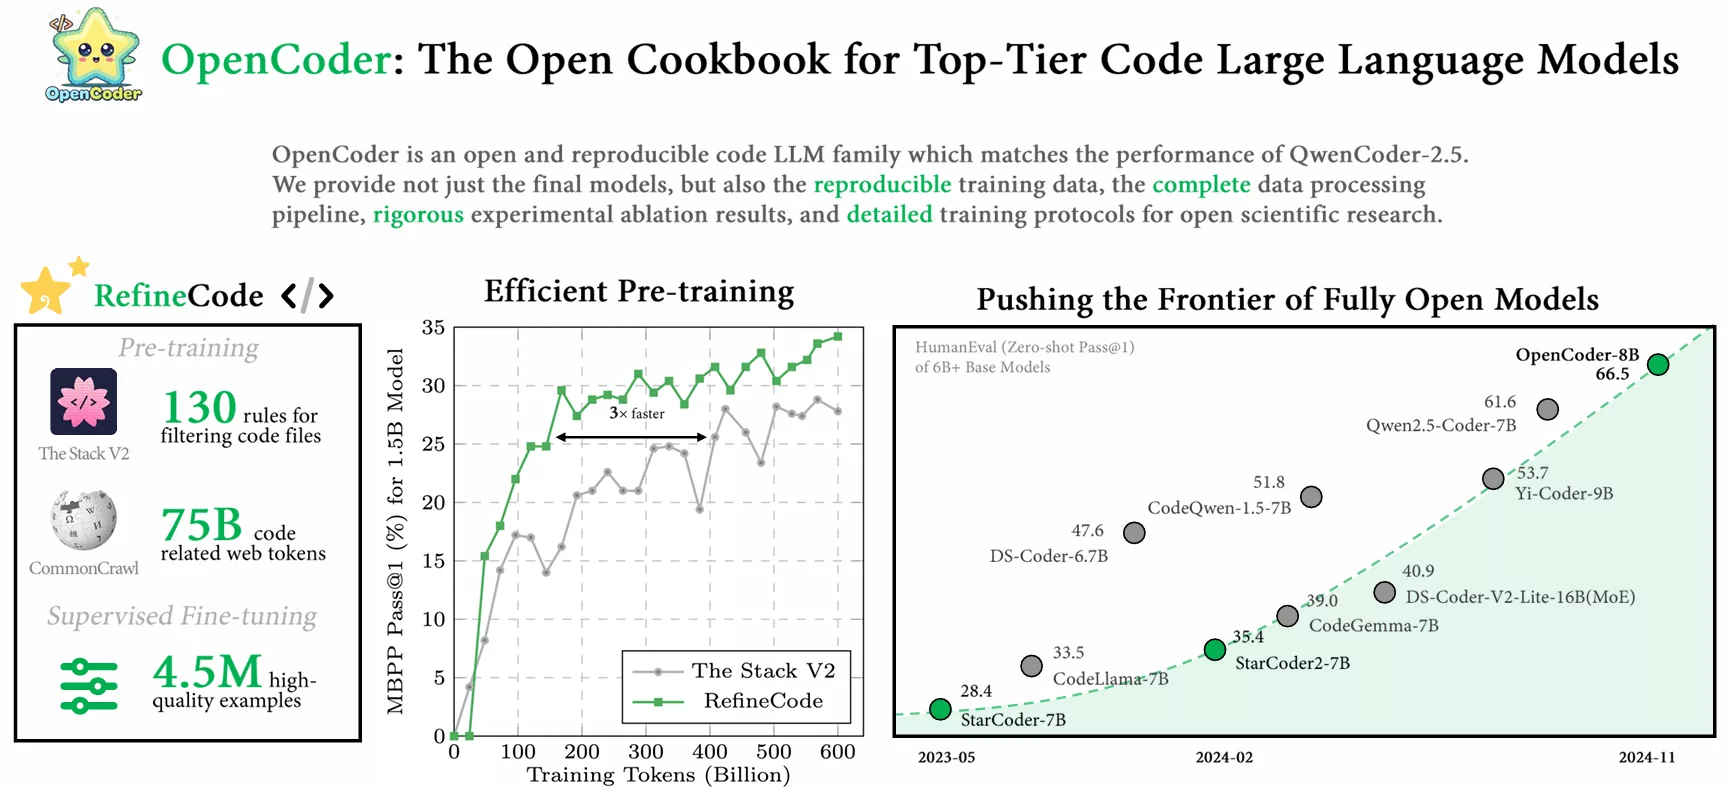
官方把 OpenCoder 定义为「开放且可复现的代码模型家族」,关键词是可复现。它不止给出最终权重,还一并公开可复现的训练数据、完整的数据处理流程、严谨的消融实验结果与详细的训练方案。官网的说法是希望让研究者能够在此基础上构建与创新。对做研究或需要向上解释模型来源的团队,这种「连配方一起给」的开放程度,比单纯下载一个权重文件有用得多。
产品情报 / 开源代码模型与训练语料
 OpenCoder
 是开放且可复现的代码模型家族,包含 1.5B 与 8B 的基础版与对话版,支持中英双语;从零预训练 2.5 万亿 token(九成原始代码加一成代码相关网页),并公开数据清洗流程与训练语料。
深度介绍
官方把 OpenCoder 定义为「开放且可复现的代码模型家族」,关键词是可复现。它不止给出最终权重,还一并公开可复现的训练数据、完整的数据处理流程、严谨的消融实验结果与详细的训练方案。官网的说法是希望让研究者能够在此基础上构建与创新。对做研究或需要向上解释模型来源的团队,这种「连配方一起给」的开放程度,比单纯下载一个权重文件有用得多。
官方给出的口径是:模型从零开始预训练了 2.5 万亿 token,其中九成是原始代码、一成是与代码相关的网页数据;随后用超过 450 万条高质量监督微调样本做后训练。家族包含 1.5B 与 8B 两档参数,每档都有基础版与对话版,并同时支持英文与中文。官方称其性能达到顶级代码模型的水平。对中文代码场景而言,原生双语支持是它相对多数同类的实际差异点。
配套公开的预训练语料名为 RefineCode,官方描述为高质量且可复现的代码语料,规模 9600 亿 token,覆盖 607 种编程语言。它同时发布了语料元数据,便于研究者核查构成。此外项目还公开了代码与数学方向的网页语料、退火阶段语料,以及两阶段的指令微调数据集。把这些拼起来,基本等于把一整条从原始数据到可对话模型的流水线摆在了台面上。
官方特别强调做了大量消融实验,覆盖不同的数据清洗策略与训练过程,其中明确提到文件级与仓库级去重的对比实验。这类实验平时很少完整公开,但它恰恰是决定「为什么这样处理数据」的关键证据。对想在自己语料上复用这套方法的团队,这些结论可以直接省掉一轮试错;对做评审的人,也提供了可核对的实验依据。换句话说,它把「调参经验」也变成了可引用的材料。
官方模型表给出了明确差异:1.5B 档序列长度为 4K,8B 档为 8K。小档适合在有限显存或端侧跑,大档适合需要更长上下文的仓库级任务。两档都有基础版与对话版——基础版适合继续微调或做补全,对话版可以直接问答。社区还基于对话版做了多种量化格式,方便在消费级设备上加载。官方另提供了一个在线演示空间,不下载也能先试效果。
项目不仅发布最终模型,还公开了训练过程中的中间检查点,且两档参数各有对应的检查点仓库。对做训练复现或研究训练动态的人来说,中间检查点往往比最终权重更有价值:可以对比不同阶段的代码能力变化,也可以从某个阶段出发做继续训练或蒸馏。官方把这些中间产物与推理代码、评估流程一并列为已发布资源,这也是它自称「最全面开源的模型之一」的依据之一。
这里有一个容易踩的点:代码仓库与模型权重的许可不是同一套。官方代码仓库采用宽松的开源许可,可自由使用与修改;而模型权重采用的是许可方自己拟定的自定义许可,条款由 INF 技术(上海)有限公司出具,协议版本日期为 2024 年 7 月。该协议授予的权利是永久、全球、非独占、免费的,包含创建衍生作品与销售、分发,并要求再分发时向接收方提供协议副本;同时明确不授予商标使用权,且协议适用中国大陆法律。
需要如实说明的是,这条产品线的模型与数据集都停留在 2024 年 11 月,此后没有新的版本或语料发布。它目前的定位更像是一份稳定的开放研究基座,而不是持续迭代的商业模型。好在权重、检查点、语料与流程代码都还在 Hugging Face 与代码托管平台上正常可访问,核验时仍可正常下载;如果你的需求是复现与二次开发,停更并不构成障碍;如果追求最新的代码能力,则应当另找更新的模型。
产品特点
它不仅给出权重,还给出完整的数据处理与清洗代码、语料元数据与消融实验结论。对需要解释「模型是怎么来的」或要在自有语料上复用这套流程的团队,这部分的价值常常超过权重本身。
官方明确说明模型同时支持英文与中文,而多数同量级的开源代码模型以英文为中心。对中文注释、中文文档与中英混合仓库的代码问答场景,这一点能减少额外微调的成本。
配套公开的 RefineCode 语料规模为 9600 亿 token、覆盖 607 种编程语言,另有代码与数学网页语料、退火语料与两阶段指令数据。做代码模型研究的团队可以直接在同一份数据上做对照实验。
代码仓库走宽松开源许可,模型权重走许可方自定义协议——后者允许商用与再分发,但要求随附协议副本、不授予商标权,并约定适用中国大陆法律。下载前分清用的是哪一套,能省掉后续的合规争议。
最近动态
核验时项目官网、代码仓库、模型权重页与在线演示空间均可正常访问,两档四个版本的权重、语料数据集与检查点仍在原位。同时可以确认这条线自 2024 年 11 月起没有新的模型或语料发布。因此本页按「资源可用、主线停更」的口径撰写,把定位写成开放研究基座而非持续迭代的商业产品。
官方在这一时期发布了 1.5B 与 8B 两档、各含基础版与对话版的模型家族,并同步放出训练过程中的中间检查点与在线演示。官方公布的口径是:从零预训练 2.5 万亿 token(九成原始代码、一成代码相关网页),随后用 450 万条以上高质量样本做监督微调,性能对标顶级代码模型,并同时支持中英文。
同一时期项目陆续公开了配套数据:名为 RefineCode 的代码预训练语料(9600 亿 token、607 种编程语言)及其元数据,代码方向与数学方向的网页语料,退火阶段语料,以及两阶段的指令微调数据集。加上完整的数据清洗代码与文件级、仓库级去重的消融实验,构成了一套可以照着复现的完整训练方案。
OpenCoder 是一套开放且可复现的代码模型家族。官方对它的定义重点在「可复现」三个字:发布的不只是最终权重,还包括可复现的训练数据、完整的数据处理流程、严谨的消融实验结果与详细的训练方案,目标是让研究者能在同一基础上继续构建。 规模上,官方口径是从零预训练 2.5 万亿 token,其中九成是原始代码、一成是与代码相关的网页数据,随后用超过 450 万条高质量监督微调样本做后训练。家族包含 1.5B 与 8B 两档参数,每档都有基础版与对话版,并同时支持英文与中文,官方称性能达到顶级代码模型水平。两档的差异在序列长度上:1.5B 为 4K,8B 为 8K。权重托管在 Hugging Face,另有官方在线演示空间,社区也基于对话版做了多种量化格式。 配套数据是它区别于同类的地方。预训练语料名为 RefineCode,官方描述为高质量且可复现的代码语料,规模 9600 亿 token,覆盖 607 种编程语言,并附带语料元数据;此外还公开了代码方向与数学方向的网页语料、退火阶段语料,以及两阶段的指令微调数据集。项目还发布了训练过程中的中间检查点与推理、评估代码。官方强调做了大量消融实验,覆盖不同数据清洗策略与训练过程,其中明确提到文件级与仓库级去重的对比,这些结论对想在自有语料上复用该方法的团队有直接参考价值。 许可是下载前需要分清的一点:代码仓库采用宽松开源许可,而模型权重采用许可方自拟的自定义许可,由 INF 技术(上海)有限公司出具,协议版本日期为 2024 年 7 月。该协议授予永久、全球、非独占、免费、免版税的权利,包含创建衍生作品以及制造、销售、分发,并要求再分发时向接收方提供协议副本;同时不授予商标使用权,约定适用中国大陆法律,并附免责声明。 最后是需要如实说明的状态:这条线的模型与数据集都停留在 2024 年 11 月,此后没有新版本或新语料发布,目前的定位更接近一份稳定的开放研究基座。权重、检查点、语料与流程代码在核验时仍可正常访问下载;若需求是复现与二次开发,停更不构成障碍,若追求最新代码能力则应另找更新的模型。
核验信息
本页事实来自官方渠道:项目官网(可复现定位与开放清单、1.5B 与 8B 双语家族、2.5 万亿 token 的九一比例、RefineCode 语料规模与语言数量、贡献者所属机构、论文出处)、官方模型卡(两档序列长度、基础版与对话版划分、450 万条以上微调样本、许可名称与协议链接)、权重与数据集组织页(各版本权重、退火语料与两阶段指令数据、语料元数据)、在线演示空间、代码仓库(宽松开源许可与星标数),以及许可协议原文(授予的权利范围、再分发要求、商标与适用法律条款、版本日期与出具方)。页内未列出第三方模型名称。价格与状态核验于 2026 年 9 月 22 日。
OpenCoder介绍页面对您是否有帮助?